
Technologie
Een digital twin van de kas: van enkele planten in Omniverse tot een complete kas in Blender
20 nov. 2026 · Vratislav Beneš
In Blender bouwden we een fotorealistische digital twin van een tomaten- en een paprikakas, die we eerder in Omniverse hadden. Neurale netwerken die uitsluitend op synthetische beelden zijn getraind, herkennen beton, buisrails, vruchten en plantenstengels op echte robotfoto’s. De digital twin simuleert ook ledbelichting voor de tuinbouw. Hoe hebben we dat gedaan, waarom lukte het drie jaar geleden niet en waar blijven echte beelden waardevol?
Waarom een virtuele kas
Scout rijdt op buisrails tussen de rijen en fotografeert de planten. Maar in een echte kas zijn veel situaties niet zomaar uit te proberen. Andere buisrails of ander beton op het hoofdpad? Die zijn niet even te vervangen. Andere belichting of een jong gewas in plaats van een volgroeid gewas? Dat kost tijd. Tomato brown rugose fruit virus (ToBRFV)? Niemand wil dat in de kas halen voor AI-trainingsdata. Op een zware aantasting of zieke plant kunnen we ook niet simpelweg wachten. Bovendien moet het systeem worden aangepast aan elke nieuwe kas of elk nieuw ras. En wat als de klant ledbelichting gebruikt? Er zijn genoeg vraagstukken waarvoor trainingsdata ontbreken.
Daarom wilden we een digitale omgeving waarin we die varianten eenvoudig kunnen testen. We stellen het tijdstip, de belichting (daglicht en ledlicht) of de planthoogte in en zien direct wat de robotcamera zou waarnemen.
Ook snelheid is een belangrijke reden. Voor een nieuwe kas, een nieuw ras of een zeldzame ziekte of plaag willen we niet maandenlang beelden verzamelen en annoteren. We modelleren de situatie en bereiden het systeem erop voor, nog voordat die op grote schaal in de kas voorkomt.
Drie jaar geleden deden we onze eerste poging in NVIDIA Omniverse. De virtuele kas werkte, maar op een RTX 4090 konden we maar een paar planten simuleren. Een echte rij heeft er honderden. En een productiekas heeft 200 tot 300 van zulke rijen.
Tegenwoordig ligt dat anders. Blender heeft MCP (Model Context Protocol), dus een taalmodel zoals Claude, ChatGPT, Gemini of zelfs een lokaal model zoals Gemma kan erin modelleren. In plaats van in de editor te klikken, beschrijft u wat u wilt, en het model schrijft en voert de code uit die de scène bouwt. De renders draaien dan op een GPU-server, niet op een werkstation.
Stap 1: een enkele tomatenplant
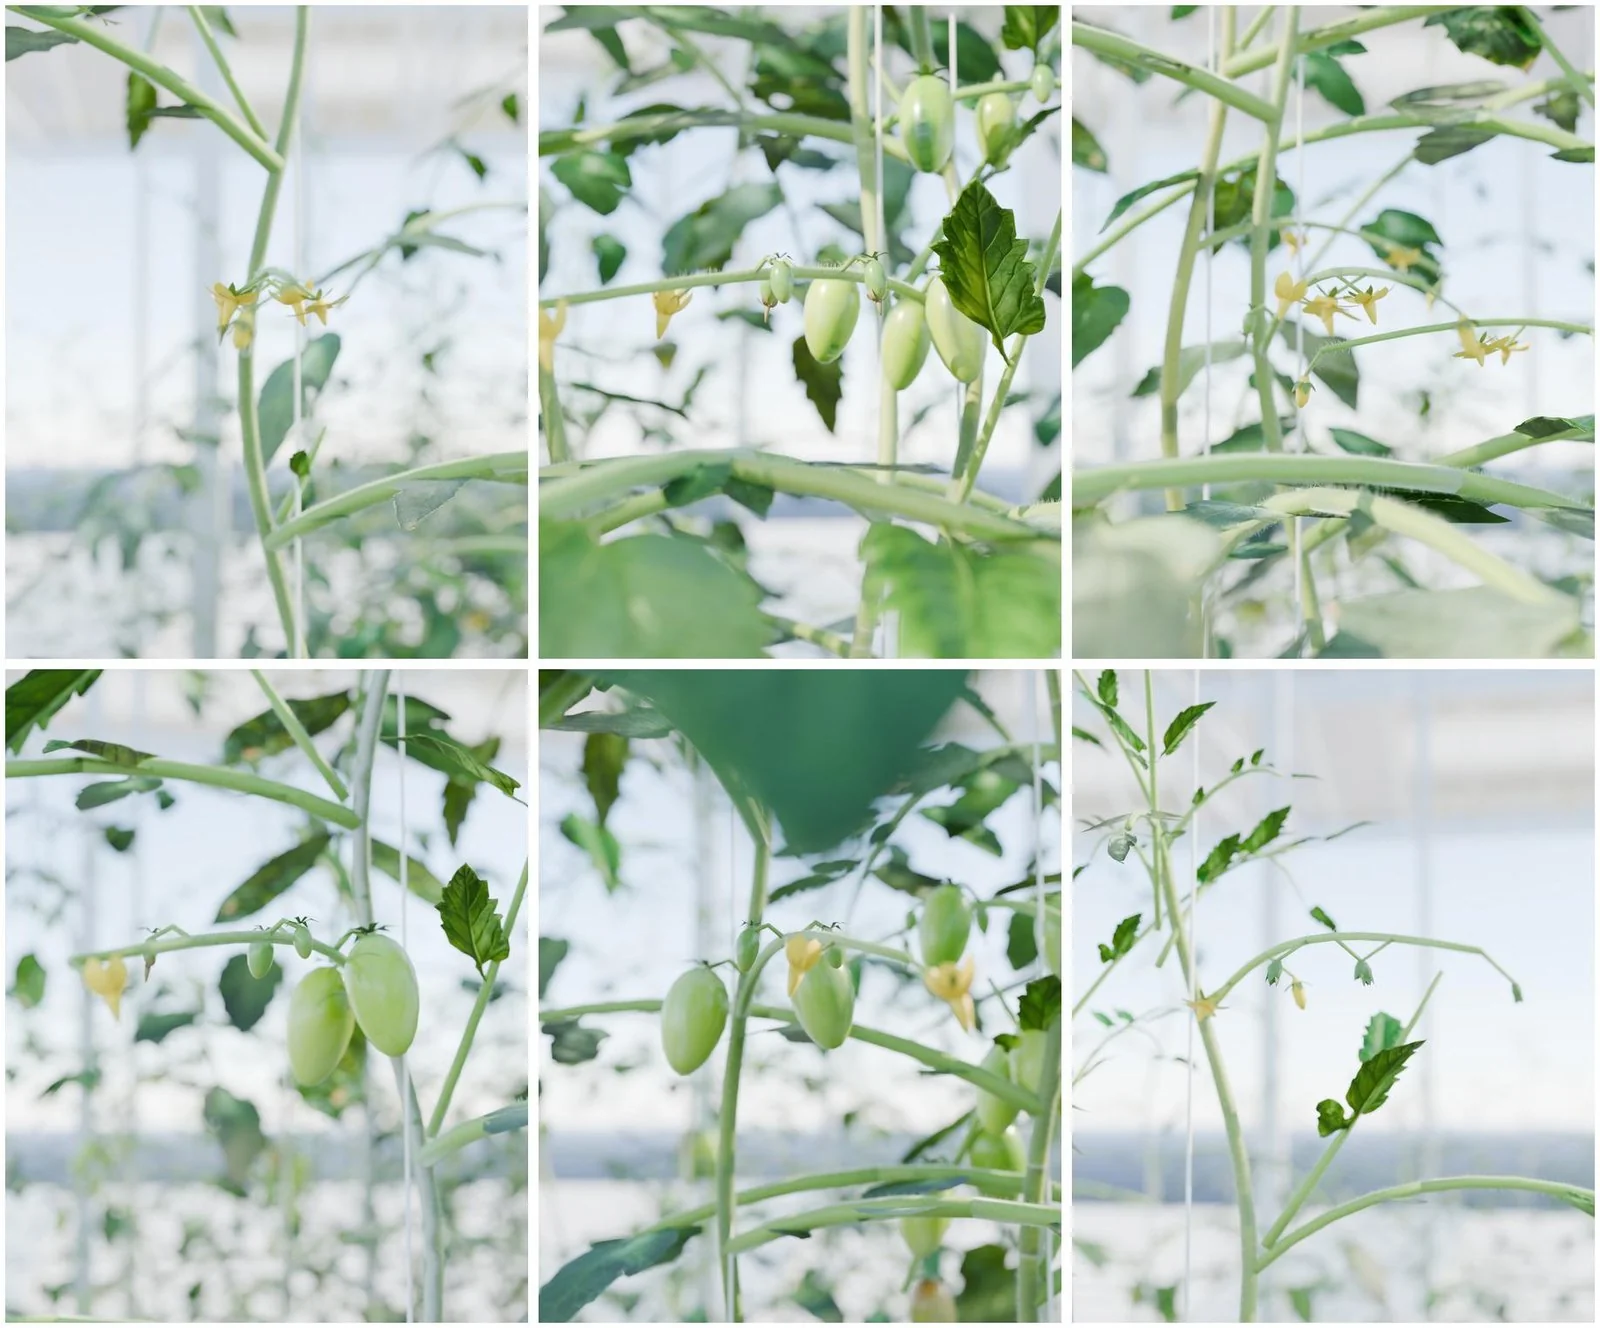
We begonnen met het importeren van een parametrische tomatenplant, gemaakt door onze collega Adam, in Blender. Het allereerste resultaat zag er goed uit.
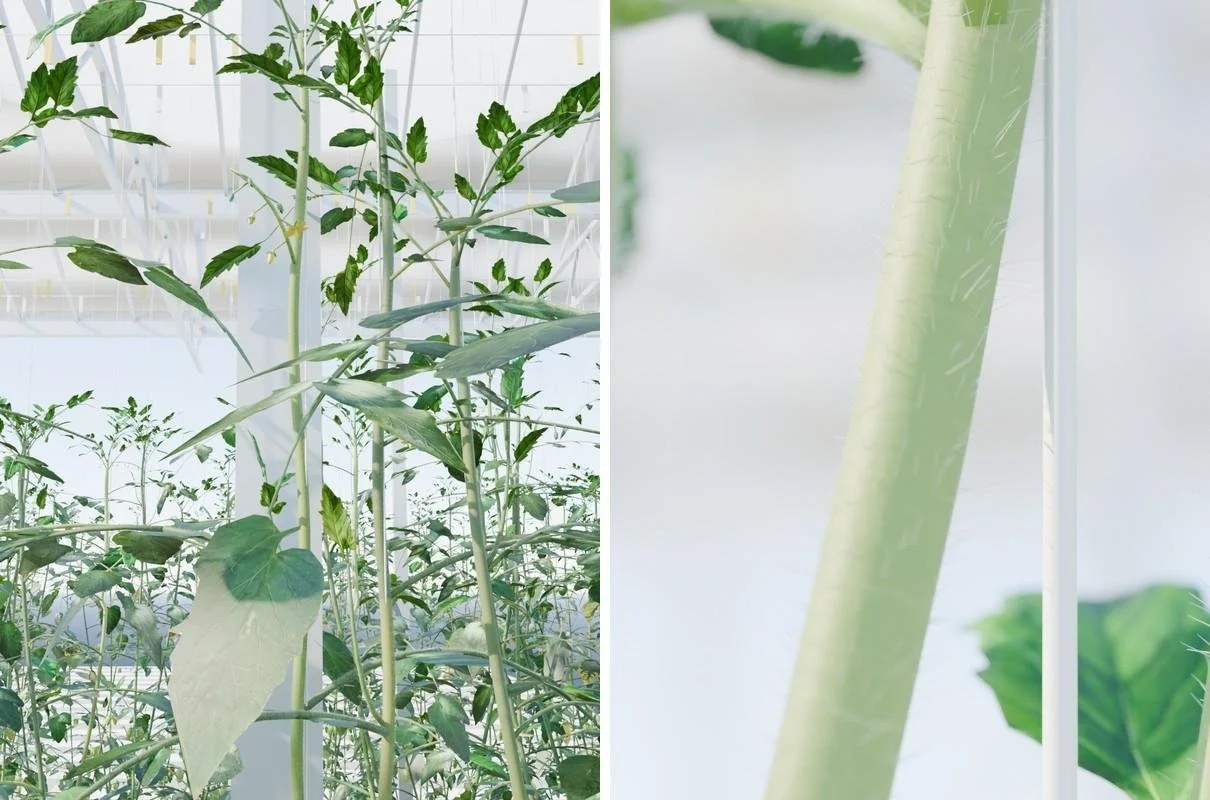
Daarna verfijnden we samen met het taalmodel het uiterlijk van de plant: de stengel in de haken en langs het teelttouw, bladeren op basis van foto’s van echte deelblaadjes, trossen van bloem tot rijpe vrucht en haartjes op de stengel. We waren nog niet helemaal tevreden, maar wel bijzonder verrast over hoe ver we kwamen door alleen met het model te overleggen.
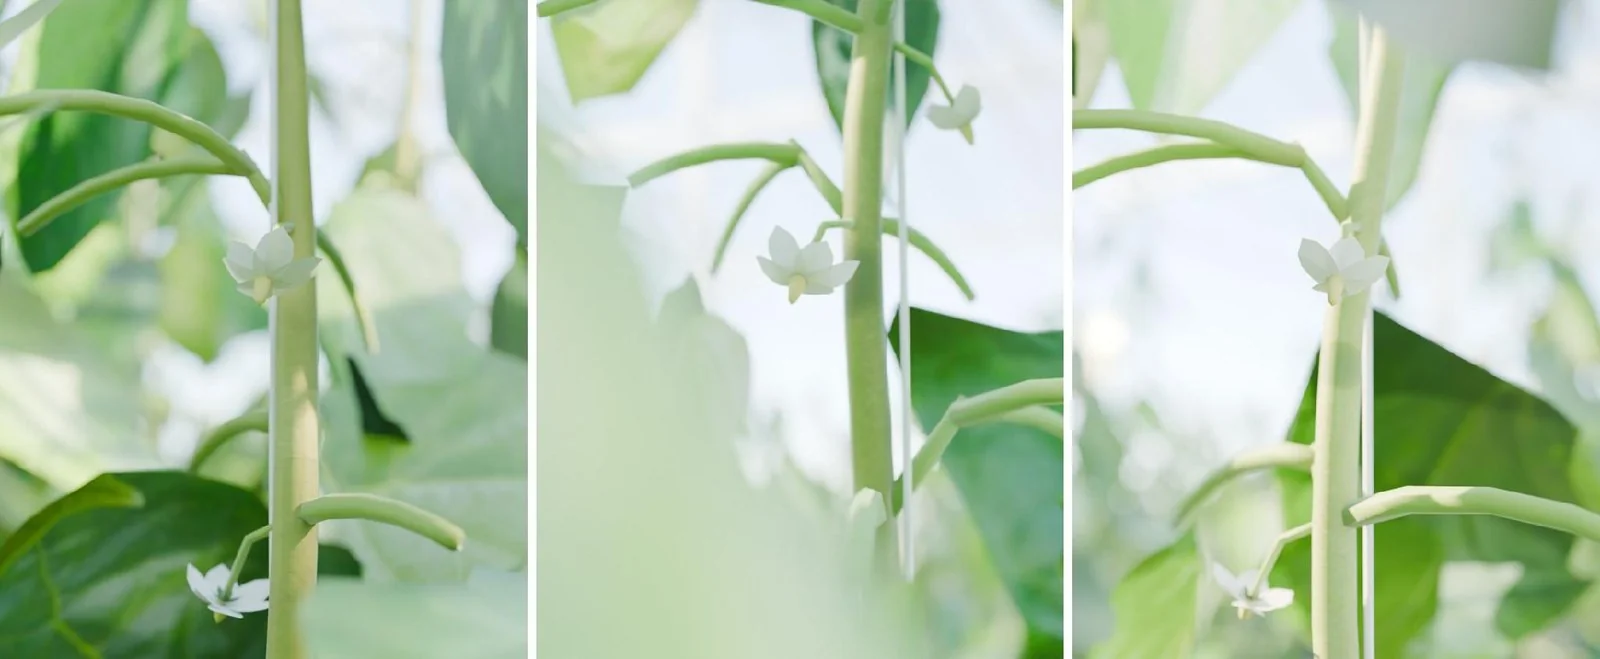
Zelfs de fijne haartjes, of trichomen, op stengels en bladstelen zijn gemodelleerd. Voor de robot is dat geen cosmetica: de haartjes beïnvloeden de lichtreflectie en de contour van de stengel in het camerabeeld.
Stap 2: een kas naar het voorbeeld van de werkelijkheid
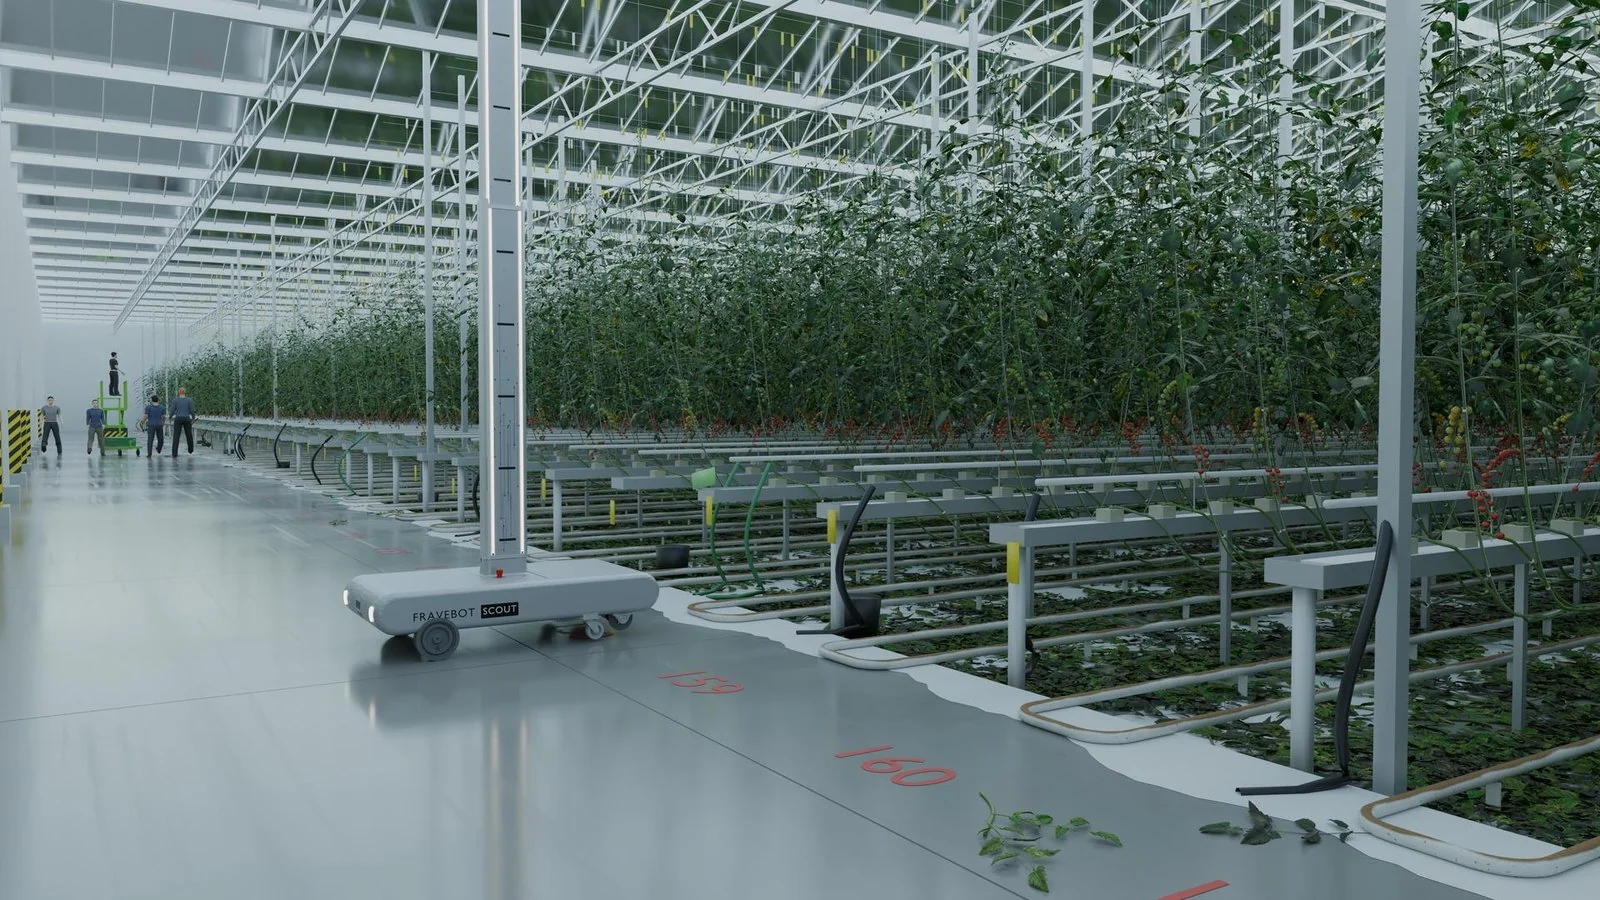
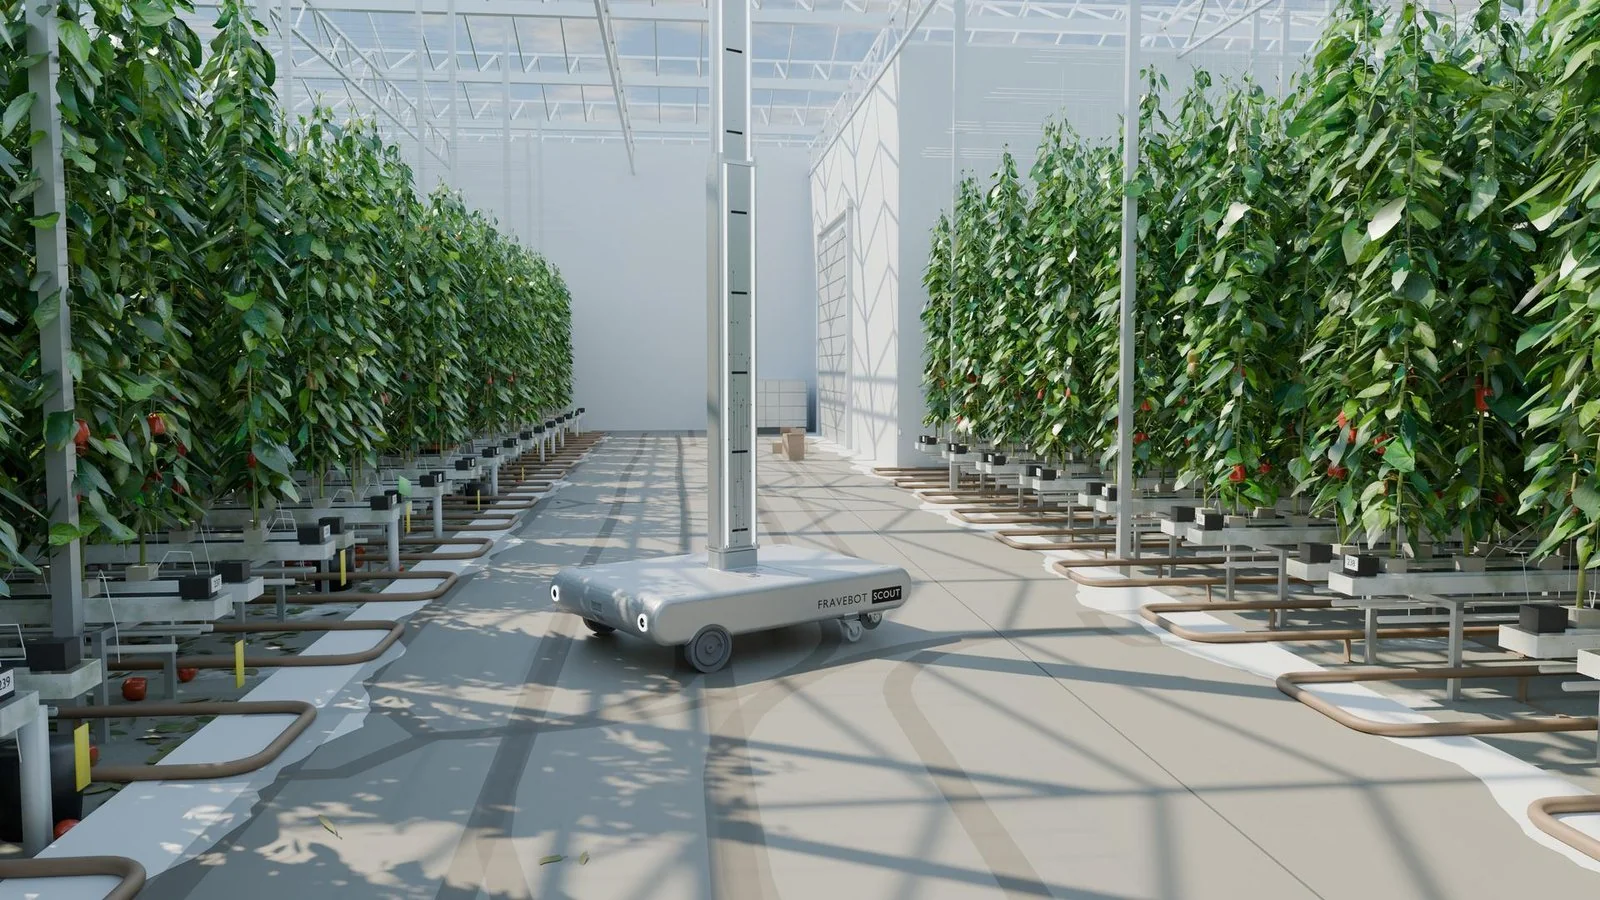
Vervolgens plaatsten we de planten in de omgeving waar Scout echt rijdt. Met foto’s en video’s uit een echte kas als voorbeeld bouwden we de scène: teeltgoten met planten, buisrails tussen de rijen, verwarmingsbuizen, grondfolie, het betonnen hoofdpad, een Venlo-dak en de zonnestand voor de juiste locatie en het juiste tijdstip. We voegden de robot uit zijn CAD-model toe, plus mensen, hoogwerkers, wagens en oogstkratten.
Opnieuw overtrof het resultaat onze verwachtingen. De digital twin heeft 26 + 26 rijen. De scène is in ongeveer 25 minuten opgebouwd en het renderen van een Full HD-beeld duurt circa 6 seconden. Dat is een wereld van verschil met de paar planten in Omniverse. Voor het renderen en trainen gebruiken we nu een server met NVIDIA RTX PRO 6000 Blackwell-kaarten met 96 GB VRAM. Die kunnen ook grote scènes met duizenden planten aan.
Om de overeenkomst met de werkelijkheid te beoordelen, bootsten we twee echte robotvideo’s na: een rij inrijden en over het hoofdpad rijden. We bepaalden het cameratraject rechtstreeks uit de echte video en speelden het in de digital twin opnieuw af.
De digital twin simuleert ook kunstlicht. Boven de paden plaatsen we Philips-armaturen met verschillende lichtrecepten. Vruchten en bladeren krijgen een andere kleur doordat ze dat licht verschillend reflecteren. Tuinbouwleds combineren rood, blauw, wit en verrood. De verhouding en lichtopbrengst veranderen gedurende de dag. Vanuit dezelfde scène maken we beelden onder al die lichtomstandigheden. Zo kunnen we de modellen daarop voorbereiden voordat de robot in zo’n kas aankomt.
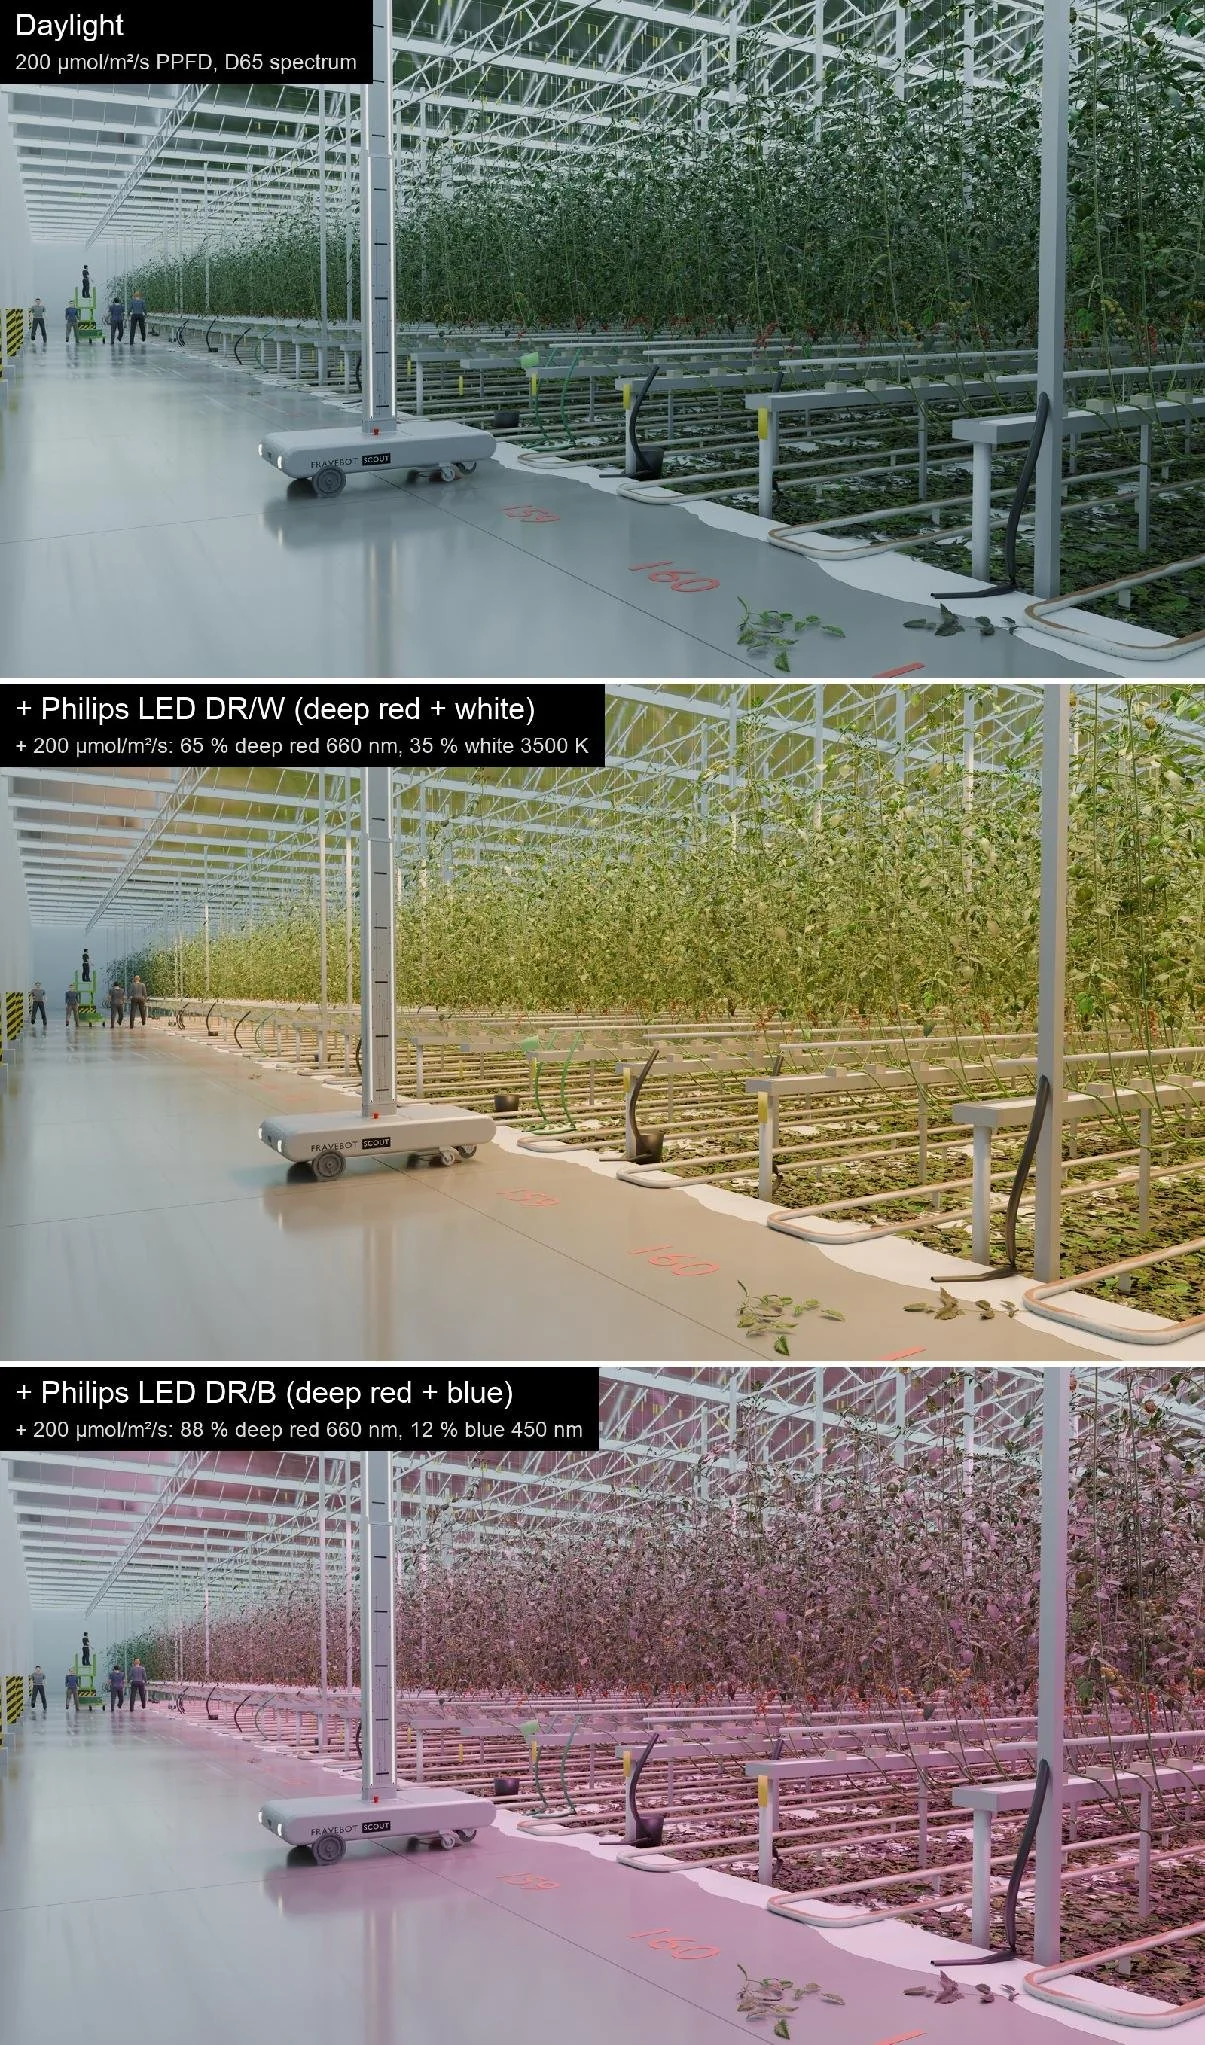
Scèneparameters:
| daglicht | + LED DR/W | + LED DR/B | |
|---|---|---|---|
| PPFD op het gewas | 200 µmol/m²/s | 200 µmol/m²/s | 200 µmol/m²/s |
| spectrum (aandeel fotonen) | D65 | 65% dieprood 660 nm, 35% wit 3500 K | 88% dieprood 660 nm, 12% blauw 450 nm |
| PAR-straling | 44 W/m² | 38 W/m² | 38 W/m² |
| energie per µmol fotonen | 0,22 J | 0,19 J | 0,19 J |
| bron | zon en lucht | 528 modules 4,8 m boven de vloer | 528 modules 4,8 m boven de vloer |
De modules hangen in een lijn boven elk gangpad (1,6 m uit elkaar), één per 2,5 m. De gekleurde ledkanalen hebben een FWHM van 20 nm. De kleuren worden berekend op basis van de spectrale gevoeligheid van de IMX708-camera van de robot met zijn IR-cut-filter op 655 nm. De Philips-spectra zijn voorlopig gemodelleerd op basis van de beschrijvingen van de fabrikant; we zullen ze vervangen door spectrometermetingen.
Stap 3: synthetische data en de eerste modellen
Een groot voordeel van een virtuele kas is dat we bij elk beeld automatisch een nauwkeurig segmentatiemasker van elk object krijgen. Niemand hoeft beton, buisrails of vruchten handmatig te omlijnen. Daarom genereerden we trainingsdata vanuit het perspectief van de navigatiecamera van de robot, ongeveer 20 cm boven het beton.
We trainden daarmee het RF-DETR-seg-segmentatienetwerk en lieten het echte kasbeelden analyseren. Het resultaat was verbluffend. Zonder ooit een echte foto te hebben gezien, herkende het model het beton, de buisrails en de lege rijen correct. Een ander model, eveneens uitsluitend getraind op synthetische data, herkent op echte video betrouwbaar mensen, wagens, hoogwerkers, kratten en emmers.
Toen we een kleiner aantal geannoteerde echte afbeeldingen aan de synthetische gegevens toevoegden, verbeterden de resultaten verder. De test werd uitgevoerd op echte beelden van andere dagen dan de trainingsgegevens:
| waar het model naar op zoek is | alleen synthetisch (1.120 afbeeldingen) | synthetische + echte afbeeldingen |
|---|---|---|
| beton van het hoofdpad, IoU | 0.87 | 0.95 |
| rail voor de robot, IoU | 0.80 | 0.90 |
| lege rij, AP50 | 0.75 | 0.97 |
IoU geeft aan hoe nauwkeurig het masker van het model de handmatige annotatie overlapt (1 = perfect). AP50 is de objectdetectiescore (1 = allemaal gevonden zonder valse alarmen).
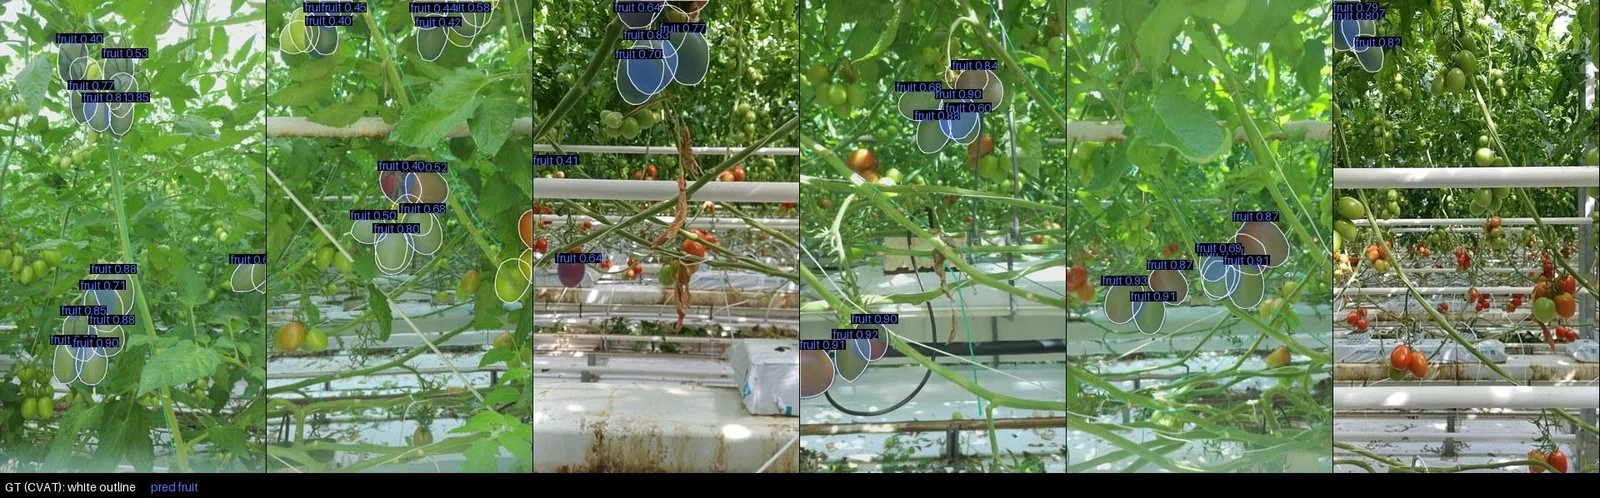
Dezelfde aanpak werkt voor tomatenvruchten. De synthetische annotaties volgen dezelfde regels als de handmatige annotaties in CVAT: alleen vruchten van de voorste plant naast de camera, en altijd de volledige vruchtcontour, ook waar een blad of stengel die deels bedekt. Een model dat op slechts 1.944 synthetische beelden is getraind, herkent vruchten op echte foto’s met een AP50 van 0,87. Met echte beelden erbij wordt dat 0,94:
| tomatenvruchten | alleen synthetisch (1.944 afbeeldingen) | synthetische + echte afbeeldingen |
|---|---|---|
| AP50 | 0.87 | 0.94 |
| IoU | 0.77 | 0.90 |
Stap 4: texturen van echte annotaties
In CVAT hebben we veel handmatig geannoteerde kasbeelden: omlijnde vruchten, stengels, bladeren en bloemen. We koppelden Blender aan CVAT, zodat het automatisch texturen uit die annotaties uitsnijdt. De vruchten in de digital twin krijgen zo de kleur en oppervlaktestructuur van echte tomaten in verschillende rijpheidsstadia. De bladeren krijgen de vorm en nervatuur van echte deelblaadjes.
Een andere bron van texturen zijn telefoonfoto’s die telers via onze webapp opsturen. De teler fotografeert en beschrijft een ziekte of plaag. Onze plantenziektekundige vult dat aan met een gedetailleerde beschrijving: waar op de plant het probleem voorkomt, hoe het er per stadium uitziet en hoe het zich verspreidt. Zo krijgt het taalmodel dat de scène opbouwt veel betere informatie.
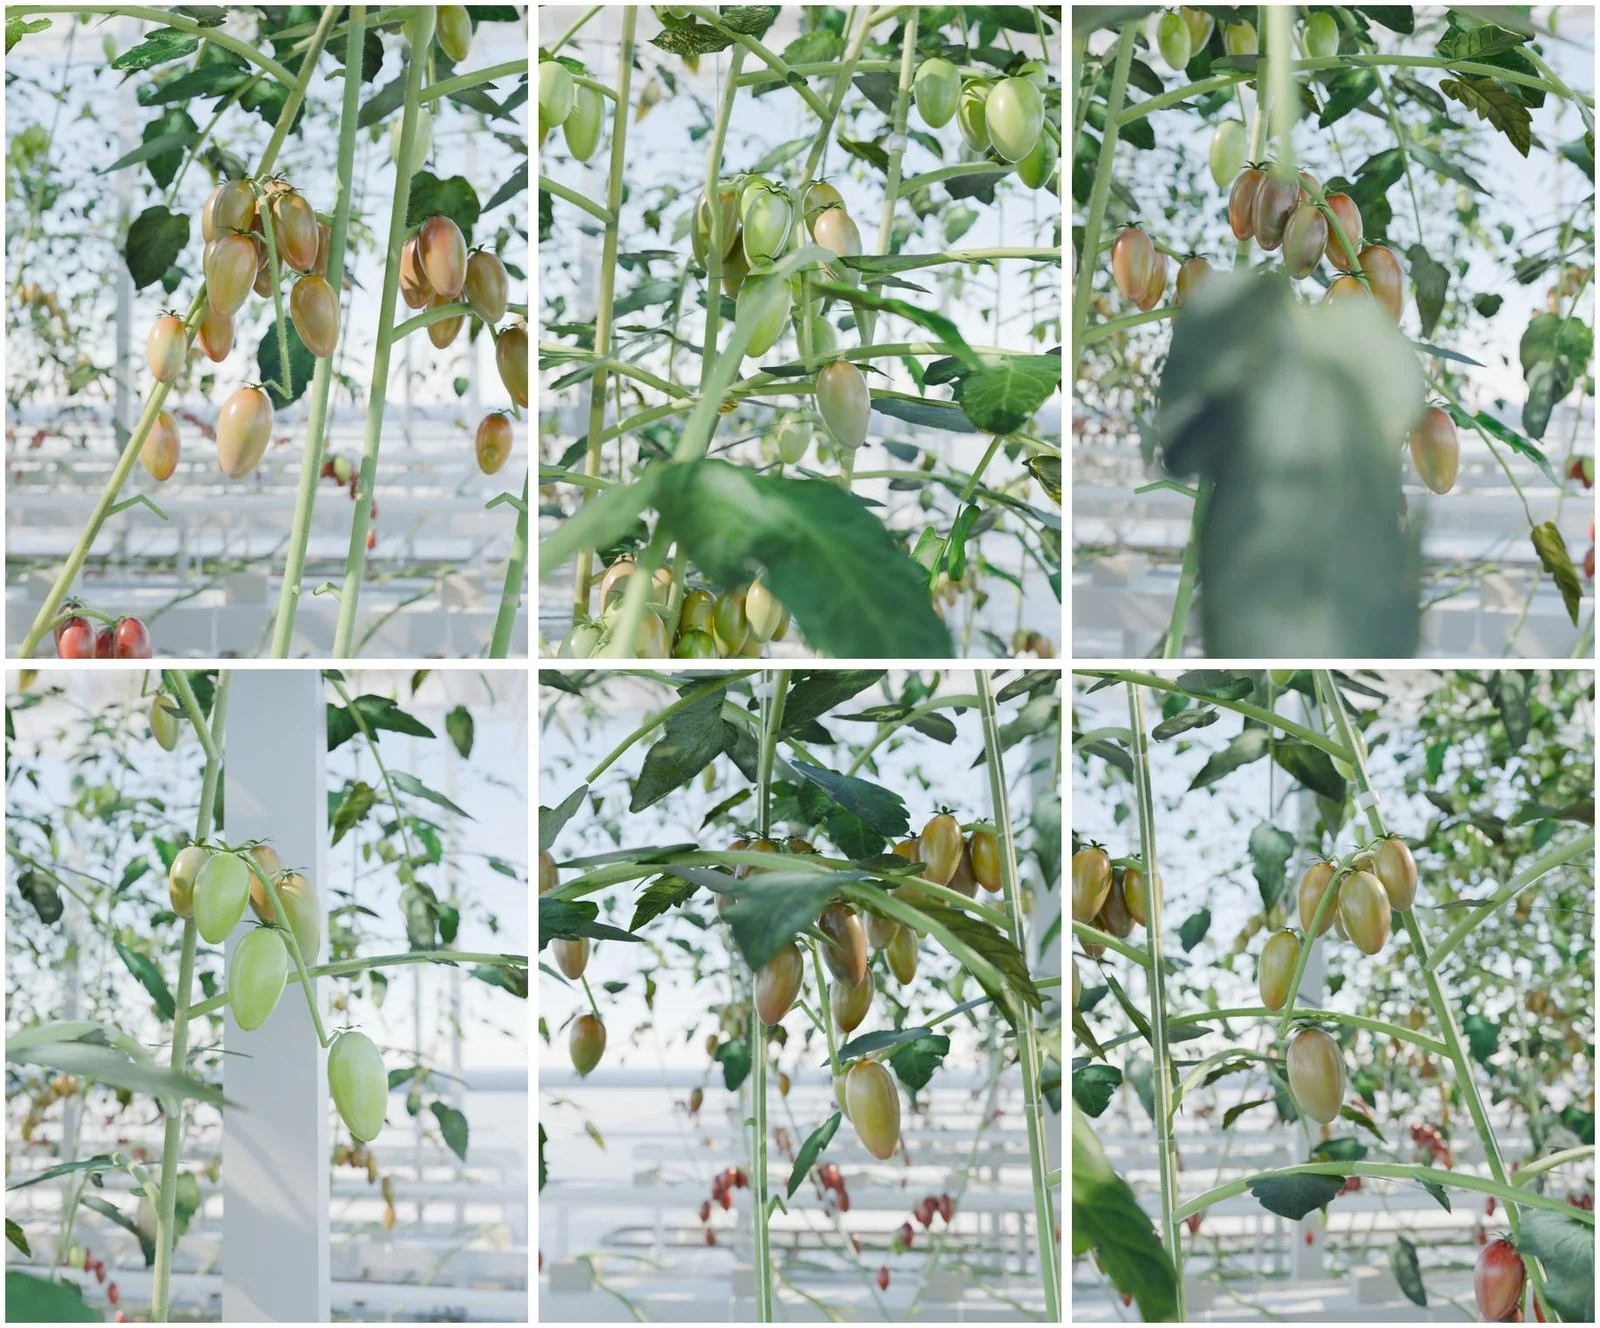
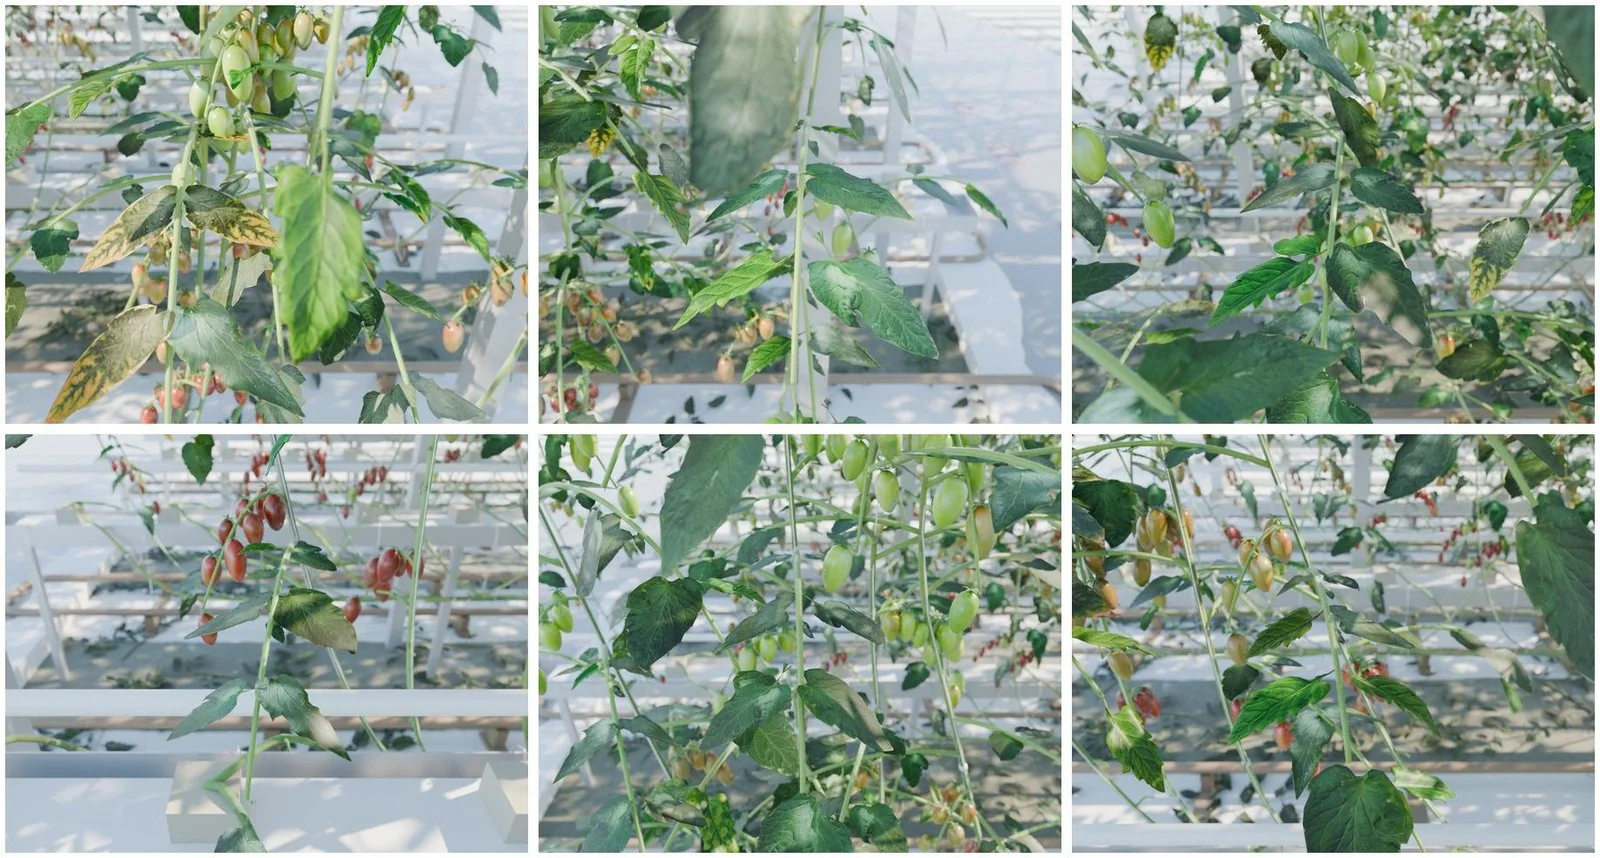
Met de nieuwe texturen hebben we de data opnieuw gegenereerd, de modellen getraind en vergeleken met echte beelden uit de kas.
Texturen van stengels uit CVAT-annotaties helpen vooral om oude, verhoute stengels op de onderste camerabeelden realistischer te maken.
Stap 5: stengels en de kop van de plant
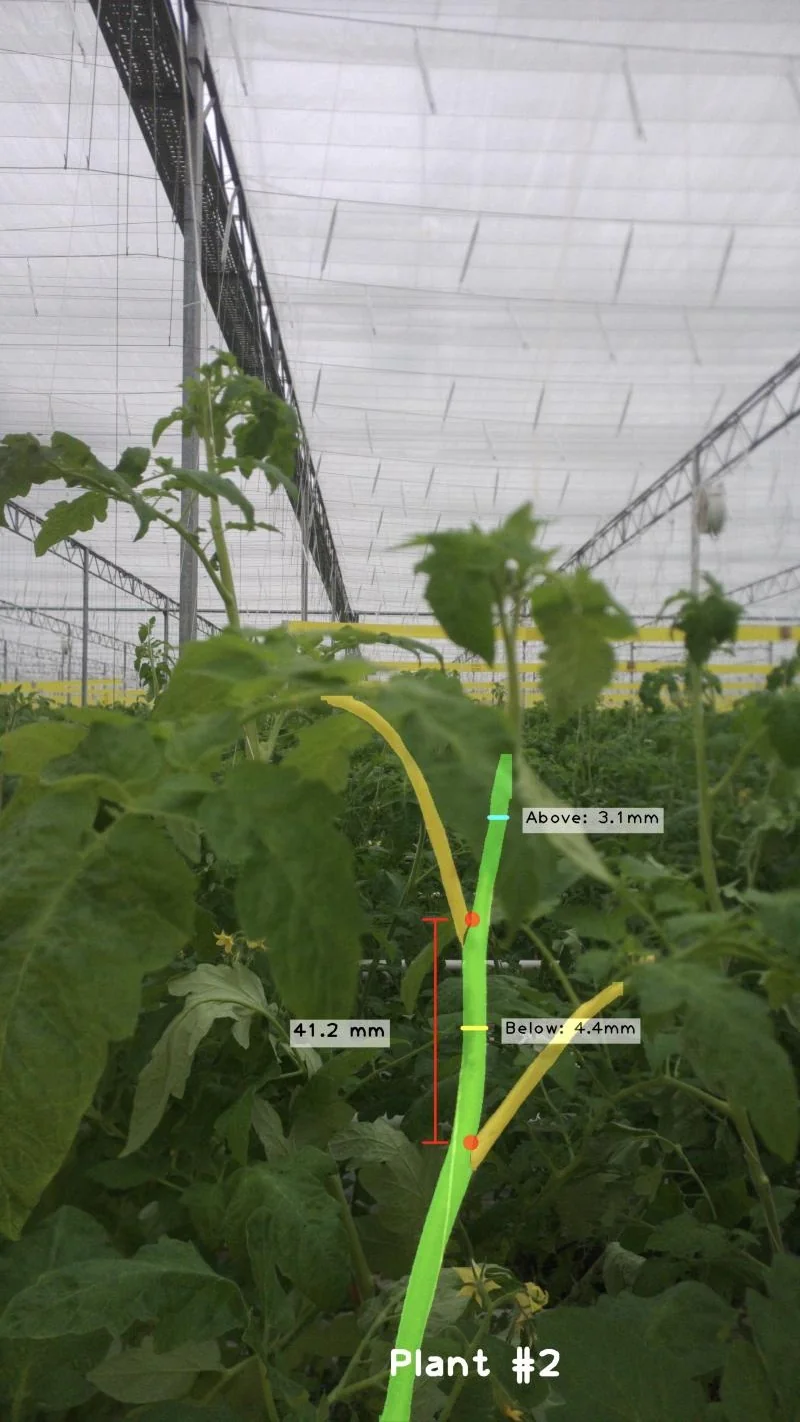
Het lastigst zijn de stengels, bladstelen, het teelttouw en de koppen op beelden van de bovenste robotcamera’s. Uit die beelden meten we de gewasgroei.
De synthetische stengelscène volgt de geometrie van rij 280 in kas 71, opgemeten door onze collega’s die stengelmetingen uit robotbeelden uitvoeren. Het teelttouw hangt 0,47 m van de camera, de planten staan 31 cm uit elkaar en de stengel is bovenin ongeveer 1 cm dik. Elke twee weken zakken de planten in de hele rij tegelijk. Daardoor hangen de touwen regelmatig verdeeld en valt de kop soms in beeld bij camera 07 en soms bij camera 08. De annotaties volgen de handmatige CVAT-regels: alleen planten in de rij naast de camera, de volledige boog van een bladsteel vanaf de stengel, en alleen het teelttouw waarlangs de plant groeit.
De aantallen objecten per beeld komen in synthetische en echte beelden goed overeen. Alleen bladstelen zijn er in de synthetische beelden ongeveer twee keer zoveel:
| per afbeelding (camera’s 07 en 08) | echte beelden | synthetische afbeeldingen |
|---|---|---|
| stengels | 1.1 | 1.3 |
| stukken teelttouw | 5.9–7.9 | 6.8 |
| bladstelen | 3.3–4.6 | 7.3 |
| koppen | 1.0 | 0.8 |
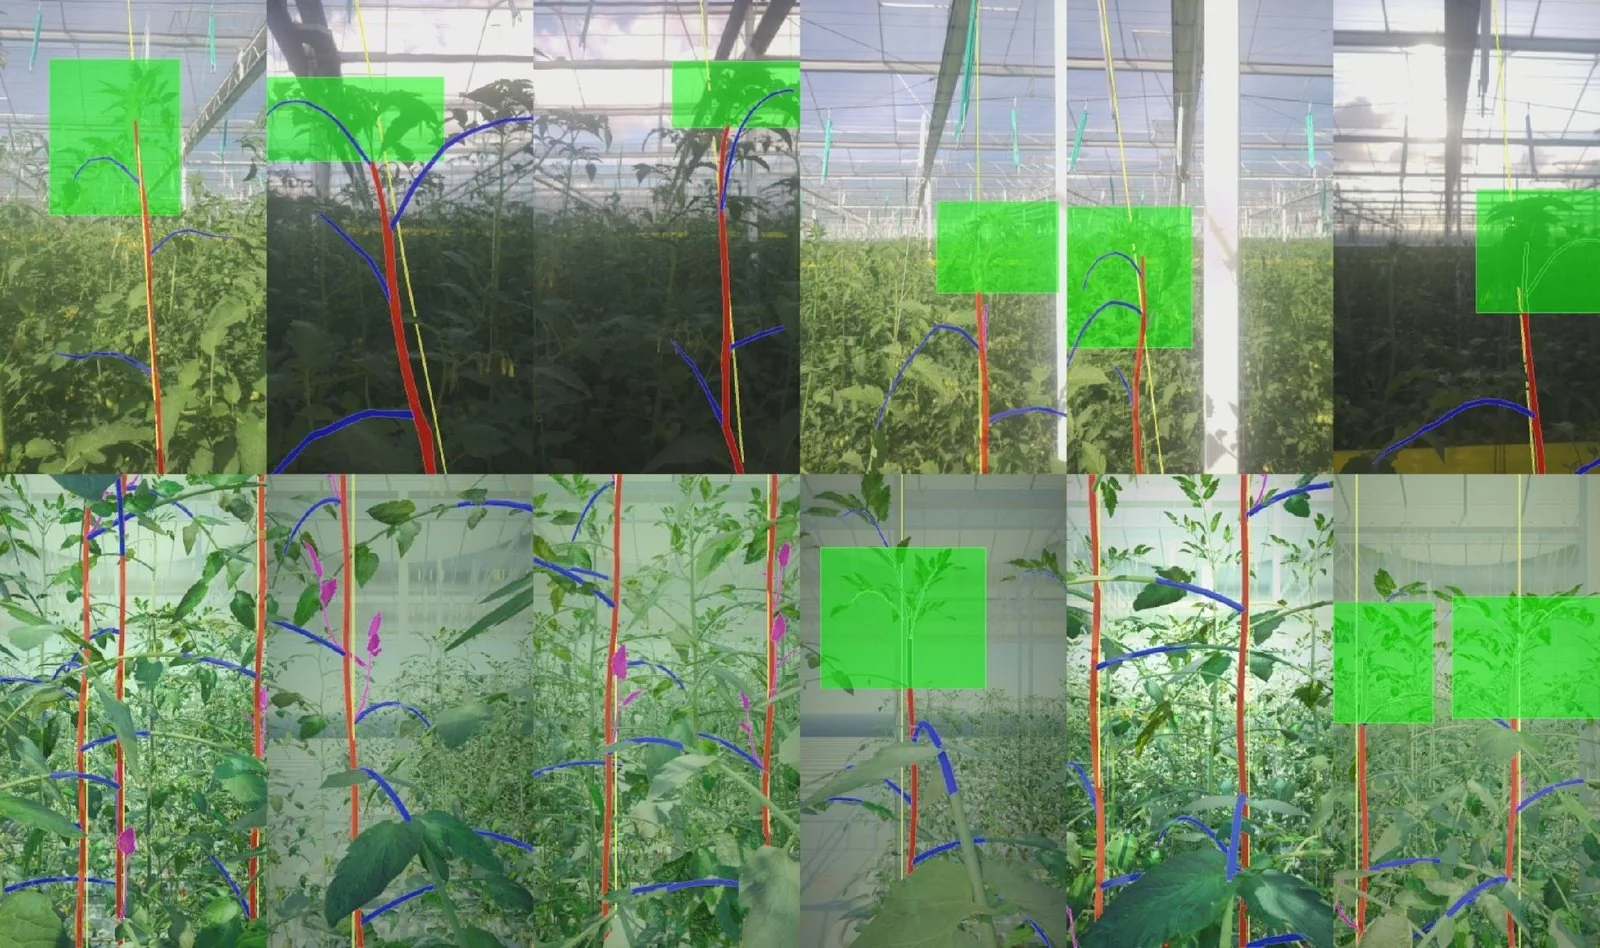
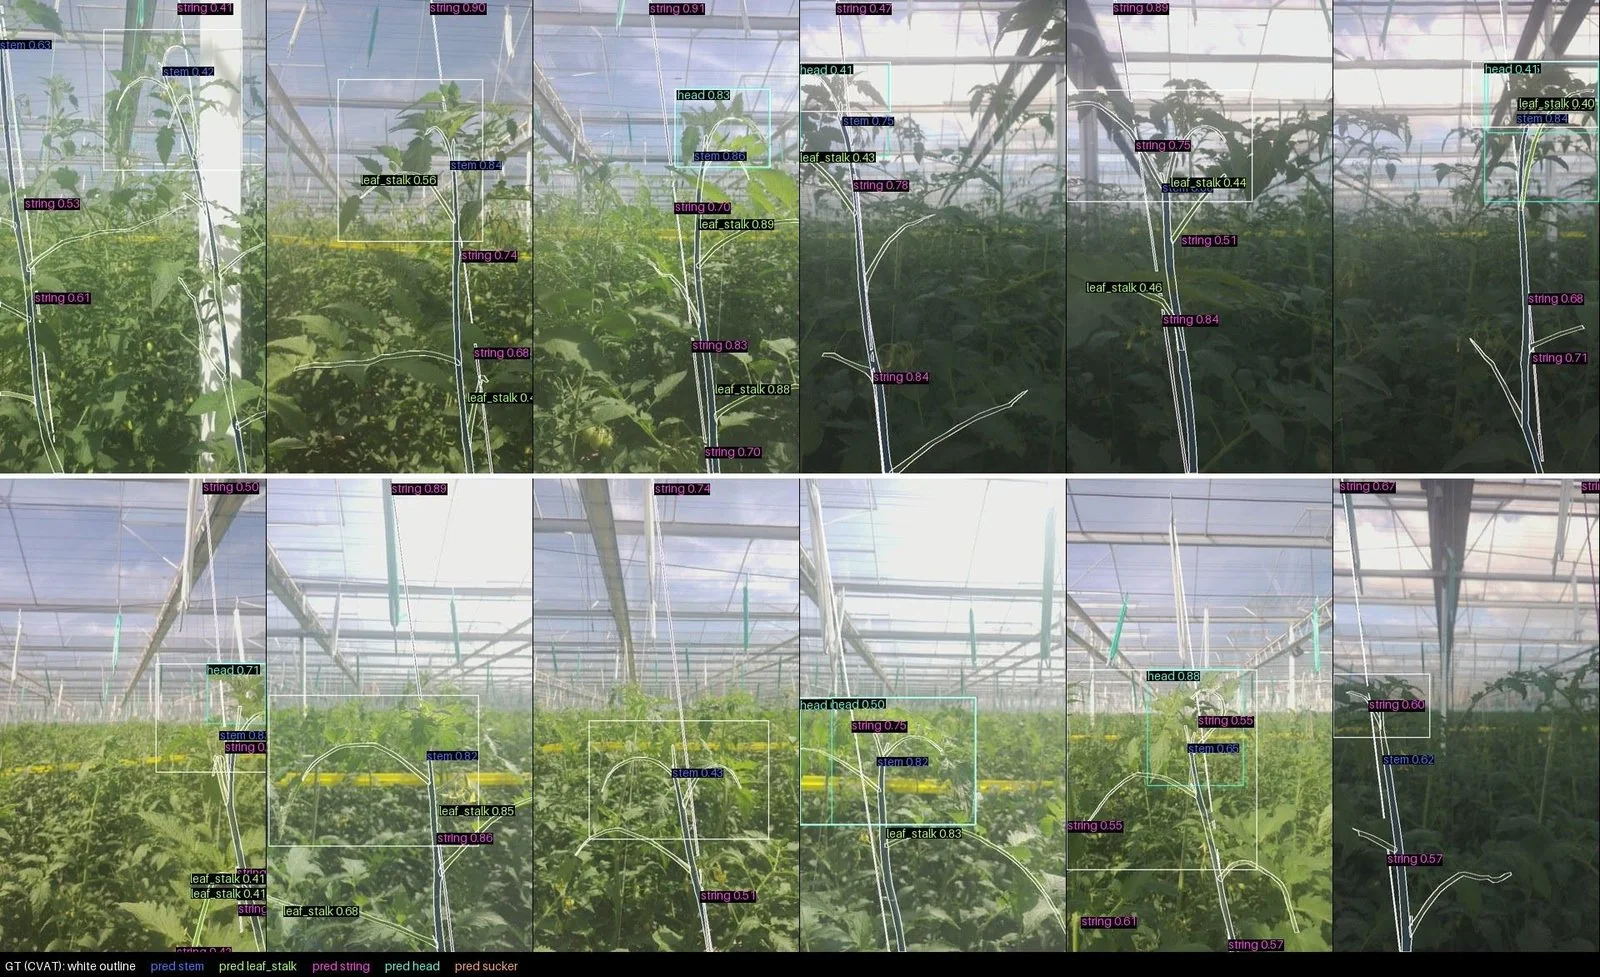
Een model dat uitsluitend op deze synthetische data is getraind, zonder één echt beeld, herkent de stengel op echte beelden van camera’s 07 en 08 met een AP50 van 0,78 en 0,69. Bladstelen en teelttouw kan het nog niet herkennen op basis van alleen synthetische data (AP50 lager dan 0,1). Een van de resterende verschillen is dat de virtuele plant meer bladeren dicht bij de camera heeft dan de echte plant, en dus ook meer bladstelen.
We vullen 1.152 synthetische beelden aan met de helft van de handmatig geannoteerde echte beelden. De andere helft, gemaakt op andere dagen, gebruiken we als testset. Dan herkent het model de stengel bij de kop met een AP50 boven 0,9. De resultaten voor bladstelen en teelttouw zijn voorlopig zwakker:
| AP50 op echte beelden | camera 07 | camera 08 |
|---|---|---|
| stengel | 0.95 | 0.92 |
| bladsteel | 0.17 | 0.23 |
| teelttouw | 0.22 | 0.22 |
Bij teelttouw komt de lage AP50 deels door de meetmethode. Een detectie telt alleen mee als die minstens voor de helft met de annotatie overlapt. Bovendien wordt elk geannoteerd deel apart geteld. In de annotatie bestaat één teelttouw uit 6–8 stukken, afhankelijk van waar bladeren het afdekken. Het model tekent het echter als één doorlopende strook. De overlap op pixelniveau, waarbij die verdeling in stukken niet meetelt, is voor teelttouw 0,35–0,44. Bij bladstelen is die net zo laag als de AP50 (0,17–0,22). Daar kan het model dus nog duidelijk beter.
Stap 6: de paprikakas
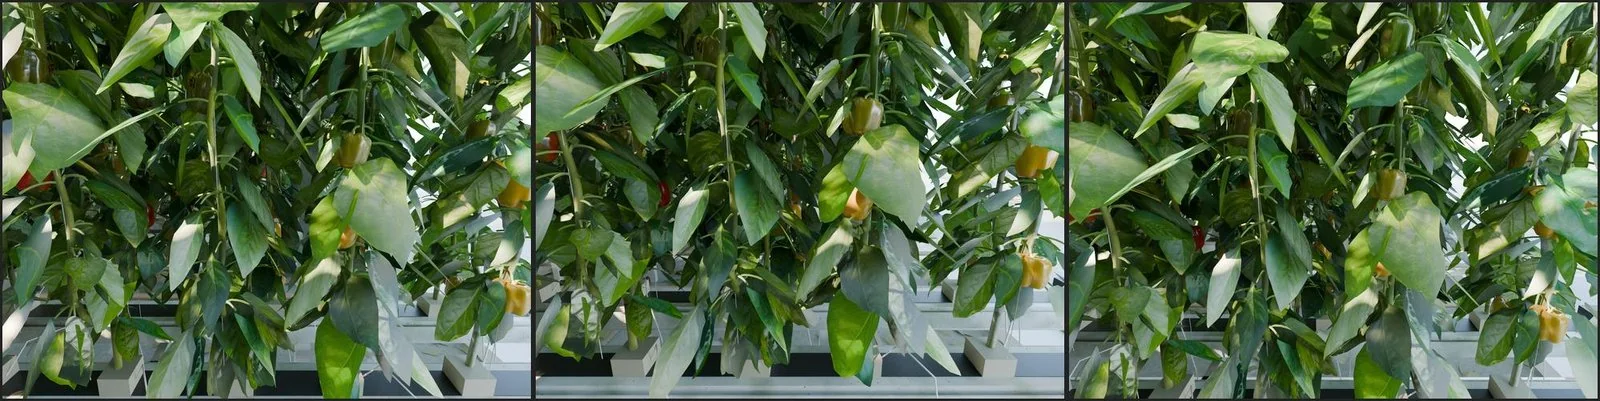
Na de tomaten hebben we op dezelfde manier een paprikakas gebouwd. We gebruiken dezelfde code, met een instelling om van gewas te wisselen, maar vrijwel al het andere verschilt. De grotere Scout 800 rijdt hier op buisrails met een spoorbreedte van 80 cm in plaats van 55 cm. Elke rij heeft twee goten naast elkaar. De planten groeien alleen omhoog, elk met twee stengels, tot ongeveer 3,5 m.
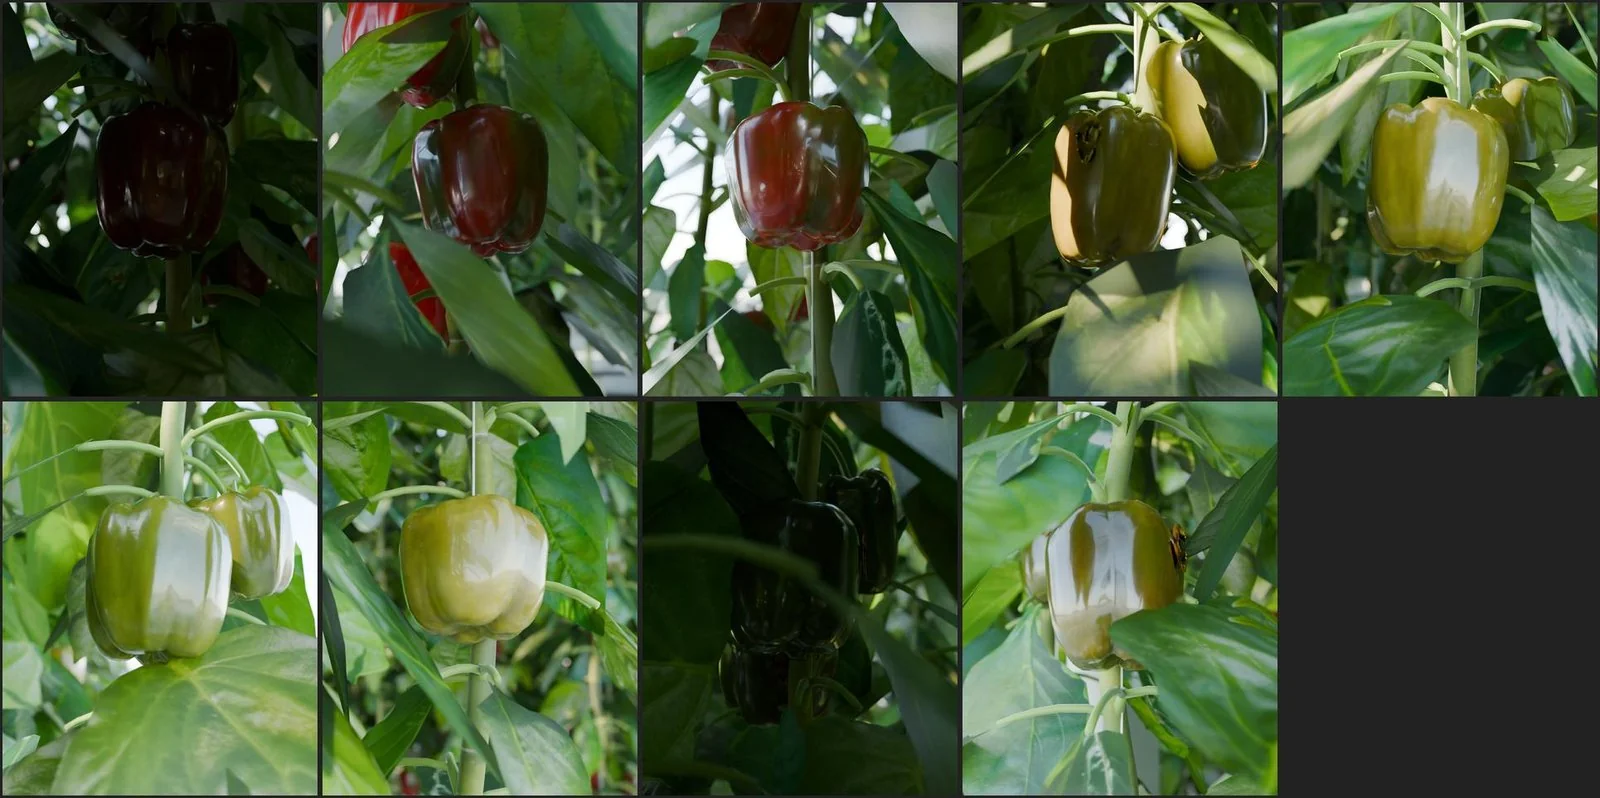
De paprika’s zijn gebaseerd op een 3D-scan van echte vruchten. Het model kan de kleur aanpassen aan het rijpheidsstadium, van groen naar rood of geel, en ziekteplekken uit CVAT-foto’s toevoegen. Ook een belangrijke plaag in paprika, een stinkwants van het geslacht Nezara, kunnen we in elk ontwikkelingsstadium in de scène plaatsen.
Waar we naartoe gaan
Het doel is een kasmodel waarop we drie dingen gaan trainen:
robotnavigatie: beton, buisrails, rijeinden en vooral obstakels op de route, bij verschillende belichting en in verschillende kassen,
gewasmetingen: stengels, bladstelen en koppen in beelden van de bovenste camera’s, waaruit de gewasgroei wordt berekend,
detectie van ziekten en plagen: gevallen die zeldzaam zijn in echte gegevens en daarom moeilijk met de hand te verzamelen en te annoteren.
Voor navigatie is de digital twin extra belangrijk. In een echte kas komt de robot dozen op het beton tegen, emmers, wagens of een medewerker die bij een rij knielt. Zulke situaties zijn zeldzaam in echte opnamen en zijn niet veilig doelbewust na te bootsen. In de digital twin kunnen we er allerlei scenario’s en varianten van maken.
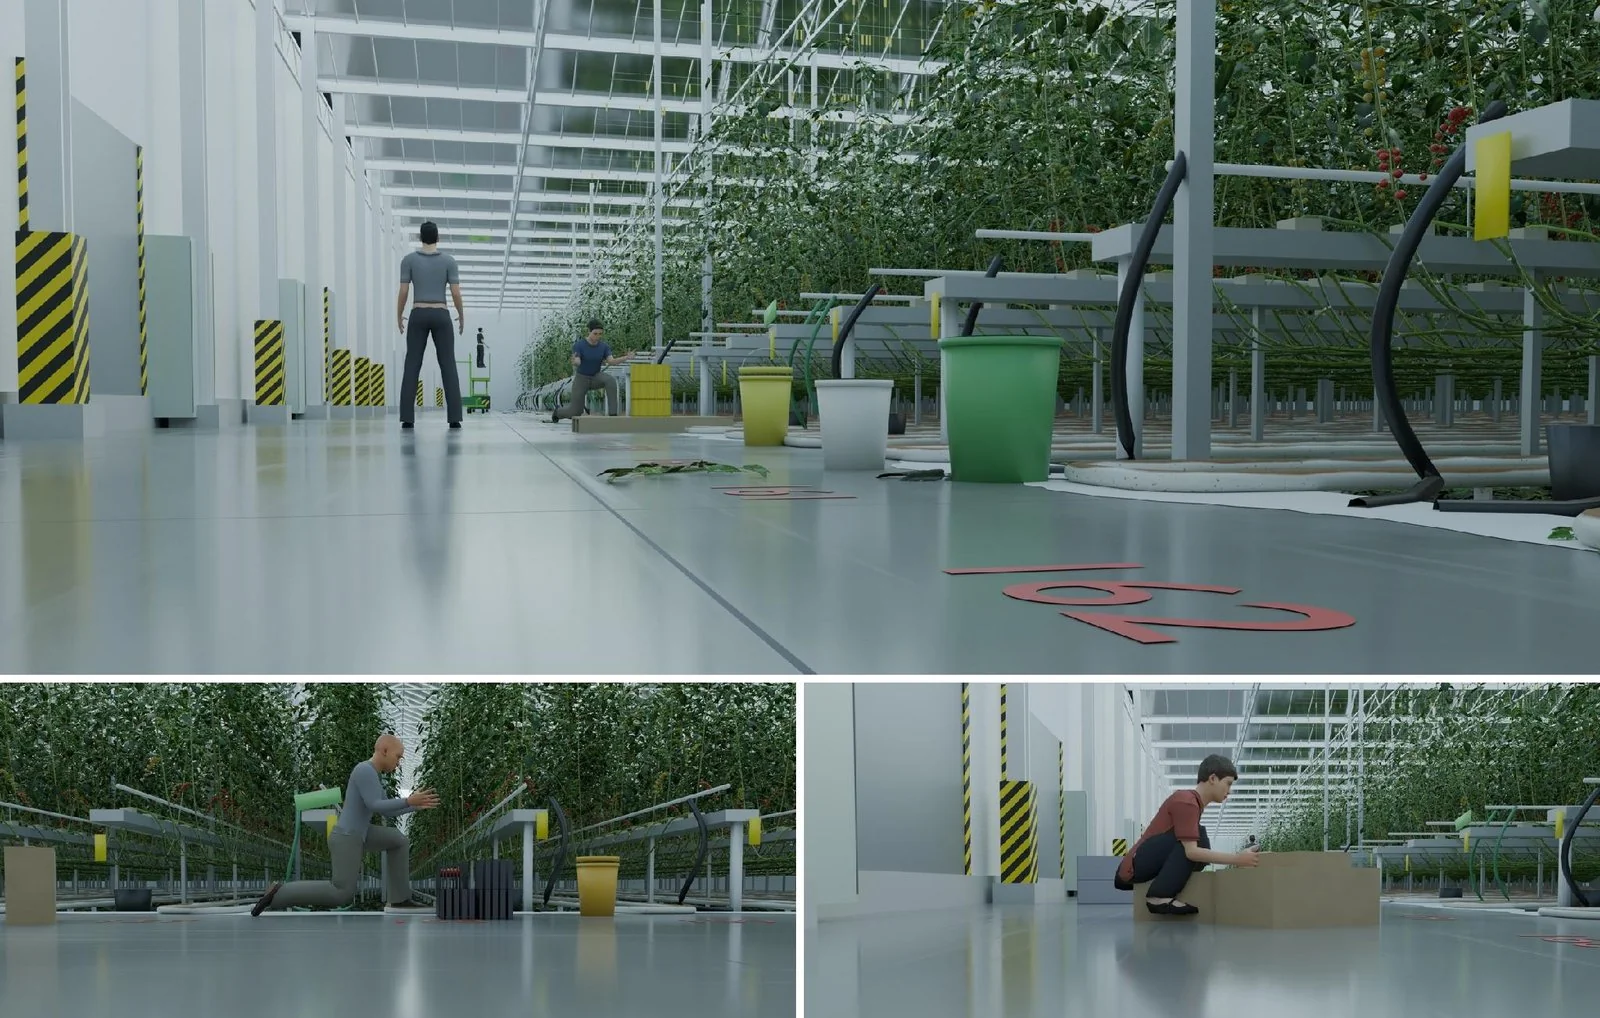
Hoe dit er in werkelijkheid uitziet, blijkt uit een video van de robot in de kas van Čerstvě utrženo:
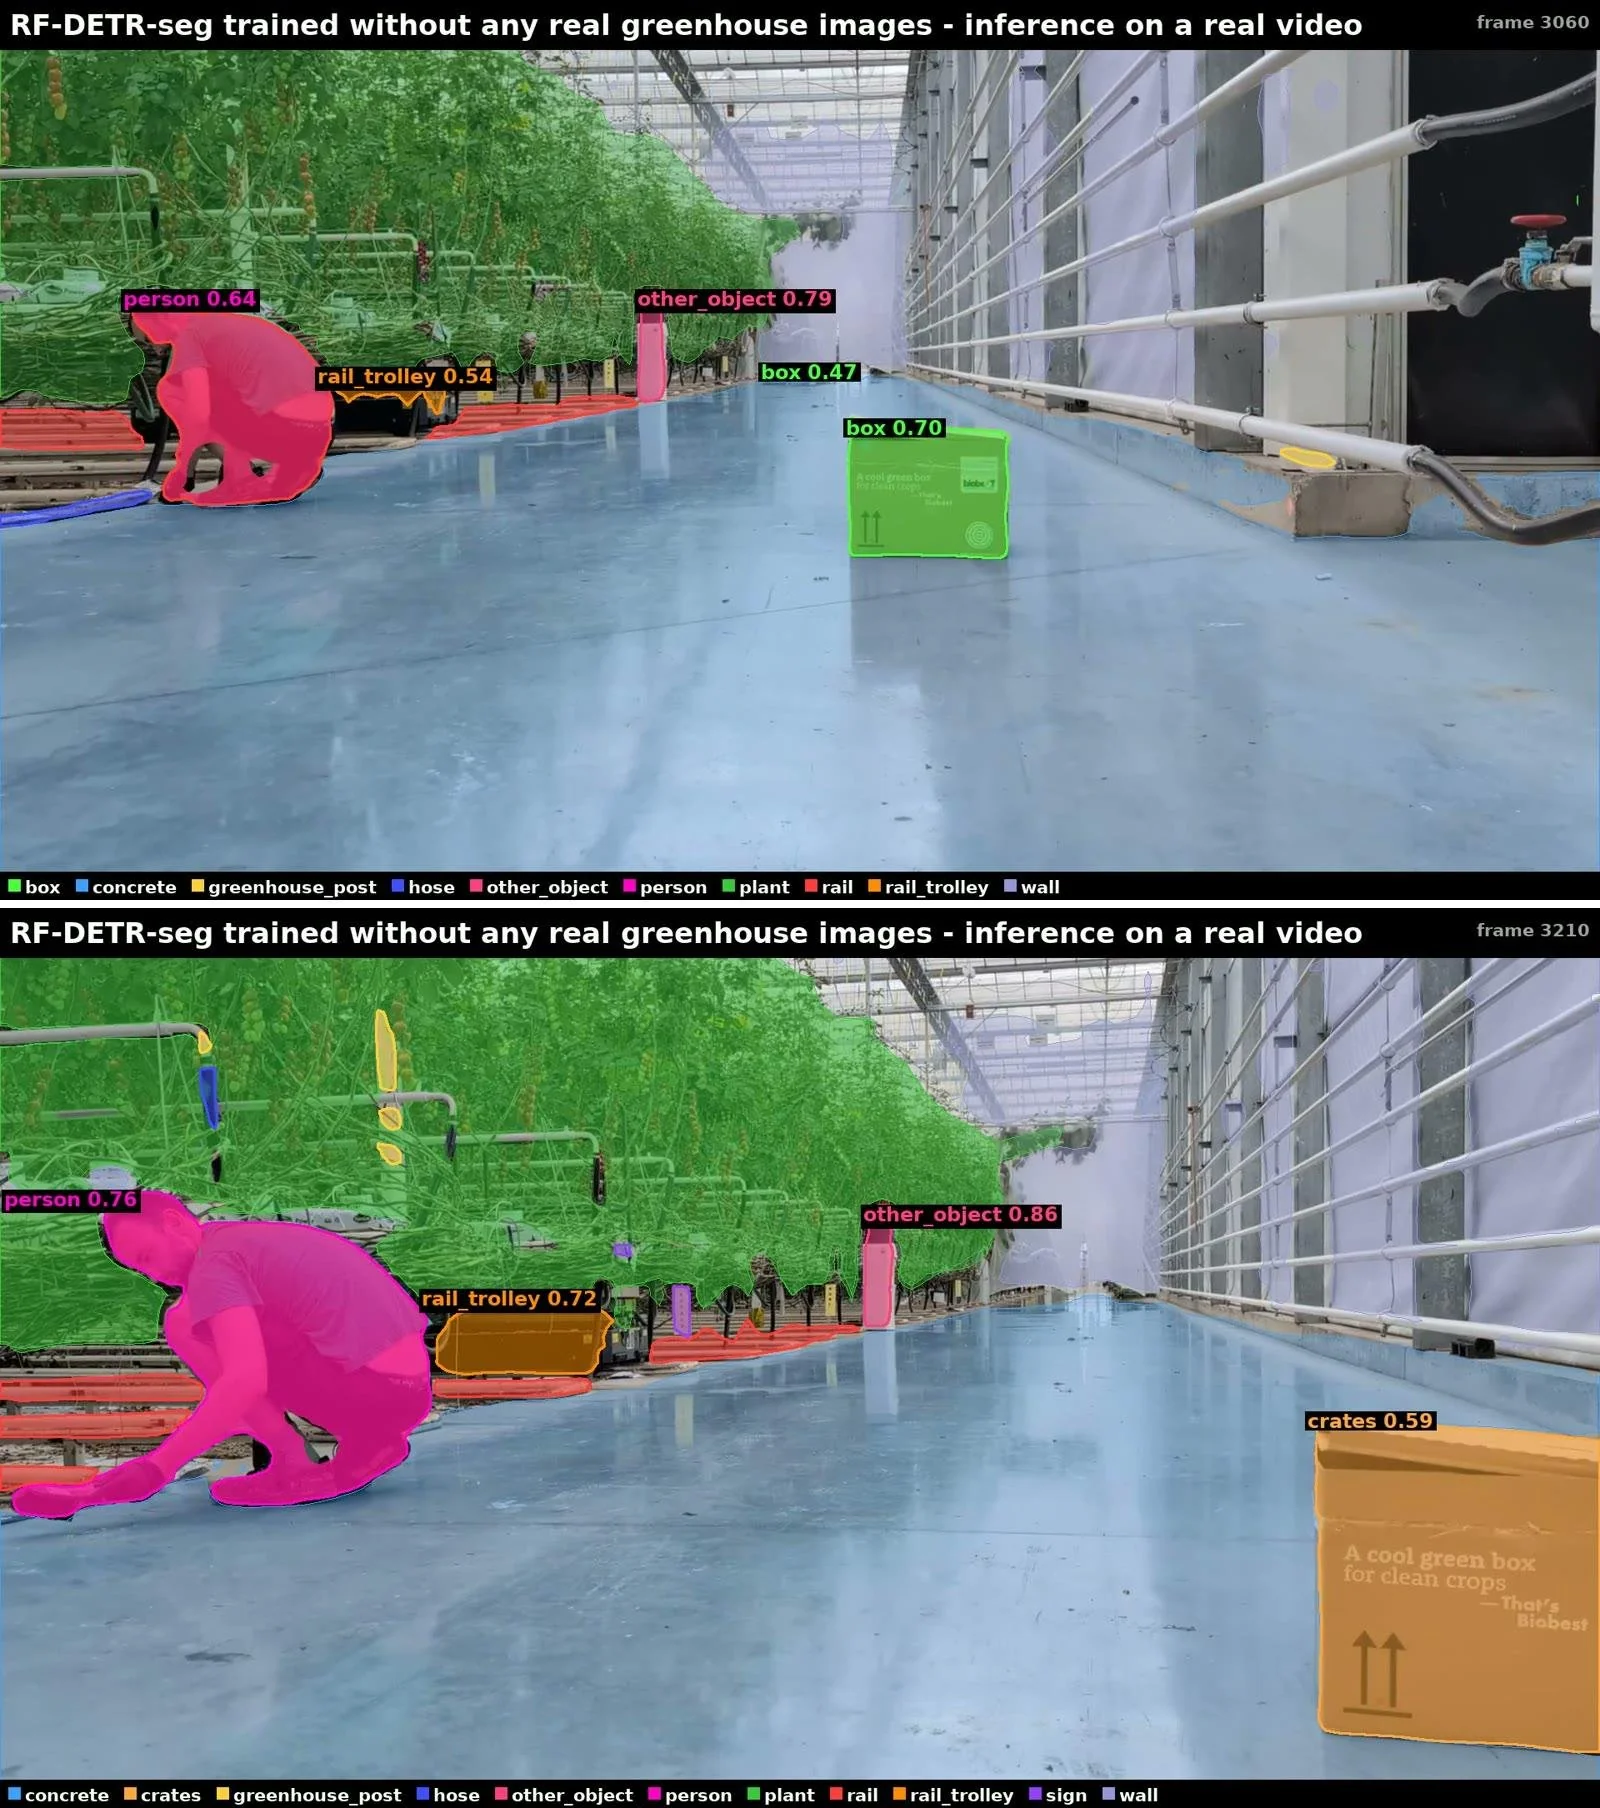
Uit deze scenario’s gaan we data genereren om twee modellen voor de robotbesturing te trainen. RF-DETR-seg herkent wat er op het beeld vóór de robot staat. Een taalmodel met een LoRA-adapter bepaalt vervolgens of de robot moet omrijden, wachten of stoppen en het obstakel melden.
Ook het fysieke gedrag van de robot wordt in de digital twin gesimuleerd, met MuJoCo. Zo testen we de besturing in een virtuele kas voordat de robot een echte kas in rijdt.
De volgende stap: de digital twin gaat regelmatig beelden uit de robotrondes vergelijken met zijn eigen renders. Op basis van de verschillen past hij zichzelf aan, zodat hij de actuele toestand van het gewas blijft weergeven.
Drie jaar geleden lag de grens bij een paar planten. Tegenwoordig hebben we hele kassen, en het meeste werk om ze te bouwen deed een taalmodel in Blender.